AI-sök
”AI kan inte rendera JavaScript” är en för enkel diagnos
Det cirkulerade ett experiment i SEO-flödena för ett tag sedan. Någon hade gömt ett meddelande i JavaScript-injicerat innehåll och testat om stora AI-modeller kunde hitta det. De gjorde inte det.
Reaktionen blev ganska snabb och många drog slutsatsen att AI kan inte rendera JavaScript.
Och där tog många den enkla vägen vidare. SSR-migreringar. Tekniska briefs till utvecklingsteam. Slides om AI-readiness.
Men slutsatsen är för enkel. Framför allt för e-handel, där kategorisidor med dynamisk produktladdning är standard. Om man fastnar vid rendering som huvudproblem riskerar man att prioritera fel, lägga resurser fel och tro att man är färdig så fort en teknisk fix är på plats.
Det som faktiskt spelar roll är något mer sammansatt. Det handlar inte bara om vad som kan renderas, utan om vad som går att upptäcka, förstå och återanvända i ett system som inte alltid ser din sajt på samma sätt som en människa gör.
Det är där frågan börjar bli intressant på riktigt.
Jag skrev nyligen om en variant av samma problem, att en kundrecension kan vara helt frånvarande i den HTMl som servern levererar, eftersom den injiceras client-side efter att sidan laddat klart. Den artikeln handlar om upptäckt i sin mest grundläggande form, alltså finns texten överhuvudtaget där crawlern tittar?
Läs också: Er bästa kundrecension finns kanske inte för Google (eller AI)
AI-crawlers fungerar olika
Innan man pratar om vad som syns och inte syns behöver man skilja på olika typer av AI-crawlers. De gör olika saker, och de påverkas av olika problem.
Träningscrawlers som GPTBot och ClaudeBot samlar in rådata för att träna modeller. De bryr sig om att innehållet finns och går att läsa. De kör inte JavaScript, men de kan hämta JS-filer. Det betyder dock INTE att de exekverar dem.
Retrieval-crawlers som OAI-SearchBot och Claude-SearchBot driver det som händer när någon faktiskt ställer en fråga i AI-sök. Det är ett levande index, mer likt traditionell sökmotorlogik än modellträning.
Här blir länkauktoritet, kontext och navigerbarhet viktiga signaler för vad som ska rankas och citeras. Internlänkar hjälper söksystem att upptäcka URL:er, förstå relationerna mellan sidor och bilda signaler om relevans och betydelse.
Perplexity är däremot mindre transparent kring en motsvarande uppdelning. Deras egen dokumentation lutar snarare mer åt att beskriva fetchar som sker “on demand” per fråga än ett systematiskt förbyggt index, så PerplexityBot är den av de tre jag skulle vara försiktiga med att placera helt i samma fack.
Sedan finns live user-fetch (ChatGPT-User, Claude-User), som triggas när en användare klistrar in en specifik URL i realtid.
När “AI-optimering” blir för grov
Det går till exempel att blockera GPTBot i robots.txt för att styra träningsdata, samtidigt som man tillåter OAI-SearchBot för citeringar i ChatGPT Search. Den möjligheten missas ofta helt i e-handelsbolag.
Och även om en sajt är “väloptimerad” för träning betyder inte det att den är bra representerad i sök. Här behöver jag nyansera mig själv lite, för det har cirkulerat som sanning att ChatGPT Search till stor del bygger på Bings Index, snarare än en egen GPTBot-crawl. Oberoende tester har sedan mitten av 2025 (bland annat från Aleyda Solis, en fantastisk “SEO-guru”) pekar mot att ChatGPT åtminstone delvis har rört sig mot att använda Googles index i stället.
OpenAI har inte bekräftat hur blandningen ser ut idag, så det säkraste att säga är vilket index som faktiskt ligger bakom en given AI-sökning inte är statiskt. Och man bör inte bygga en hel strategi på ett antagande om vilket sökmotorindex som “äger” citeringen just nu.
Så när någon säger att de “måste fixa JavaScript-renderingen” är det i bästa fall en del av problemet. Ofta är det inte ens den viktigaste delen, it depends - classic SEO-moment!
Den verkliga crawlfällan
Det här är den del som ofta förbises.
Tänk på en vanlig “Visa fler”-knapp i e-handel. Du vet den knappen som kan visa fler produkter, fälla ut produktbeskrivningen eller ett FAQ-block. Du som användare ser inga konstigheter.
Men crawlers klickar inte på knappar. Och de gissar inte URL-parametrar.
Jag körde curl (gör detta i terminal) mot en av Sveriges större e-handelssajter. Kategorisidan påstår sig visa 1 481 produkter. Råa HTML-svaret innehöll 25.
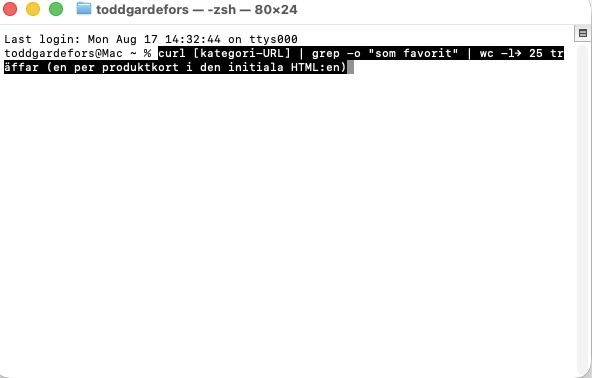
curl (kategori-URL) | grep -o “som favorit” | wc -l → 25 träffar (en per produktkort i den initiala HTML:en)Nästa test: anrop mot ?count=50-varianten av URL:en, direkt utan att simulera ett klick. 50 träffar. Servern kan rendera fler, men ingen <a href> pekar dit. För en crawler som bara följer länkgrafen från kategorisidan finns den URL:en inte.
Det intressanta är att servern ibland kan leverera fler produkter om man anropar rätt paramterar direkt, till exempel en variant av ?count=50. Då kommer fler produkter tillbaka i svaret. Det visar att det inte behöver vara ett renderingsproblem, och mer ett navigationsproblem.
Om det inte finns en riktig <a href>länk som pekar mot den URL:en, och om crawler inte klickar knappar eller gissar parametrar, då hittar de den aldrig. Oavsett hur bra resten av renderingen ser ut.
Det är en otroligt viktig skillnad som många blandar ihop, för det som finns på servern är inte samma sak som det går att upptäcka för en AI-crawler.
Crawlbar är inte samma sak som citerbar
Om man löser renderingen, bygger riktiga paginerade URL:er (typ /?page=1, /?page=2) och ser till att produkterna går att nå utan JavaScript, har man ändå inte löst allt.
För nästa fråga är: vad avgör om en produkt blir citerad i ett AI-svar?
En sitemap hjälper crawlern att hitta URL:er. Det är bra, även om det är bara en förutsättning. I ett retrieval-index avgörs citering av sådant som länkauktoritet, kontextuell relevans och hur starkt en sida hänger ihop med resten av sajten.
Det betyder att en produktsida kan vara crawlbar men ändå hamna för svagt i det lager som AI-sök använder.
Det här är skillnaden mot mitt föregående inlägg “Er bästa kundrecension kanske inte finns för Google (eller AI)” tes, där en recension bokstavligen inte fanns i den HTML crawlern fick. Här handlar det om att innehållet kan finnas, i fin server-renderad HTML, helt korrekt - och ändå aldrig bli citerad för att det inte väger tillräckligt i länkgrafen. Renderingen är en grov förutsättning, medan auktoritet är en annan. Båda behöver arbeta i en synergi.
För e-handel finns dessutom en parallell väg som inte går genom den vanliga länkgrafen
Google kan upptäcka produkter via product feeds (Merchant Center), och ChatGPTs shoppingfunktioner kan använda kategori- och produktdata från externa leverantörer.
Det gör inte internlänkningen oviktig. Det betyder att ”synlig i AI-sök” inte är ett enda tekniskt tillstånd. En produkt kan sakna organisk styrka som webbsida men ändå förekomma i ett produktindex. Omvänt kan den vara väl internlänkad men sakna pris, lagerstatus eller andra uppgifter som shoppinglagret behöver.
Diagnosen måste därför börja med vilken typ av synlighet man försöker påverka: webbcitering, produktrekommendation eller användarinitierad hämtning.
När canonical och internlänkar pekar åt olika håll
Många e-handelsplattformar exponerar samma produkt under flera URL, det är inte konstigt. Ett par svarta jeans kan både ligga under kategorin “jeans”, en varumärkeskategori eller en rea-URL samtidigt. Canonical används då för att peka ut vilken version som är originalet och ska indexeras.
Tekniskt är det rätt, och det är en lösning som många experter predikar. Här är det viktigt att man väljer rätt URL i canonicals.
Kategorisidor fungerar som “auktoritetshubbar”. Många internlänkar, men även i vissa fall externa länkar, pekar mer till kategorisidor än enstaka produkter. När en välstrukturerad kategorisida renderar många produktlänkar i HTML skickar den både länkkraft och kontext vidare till produktsidorna. Det är en stor del varför produktsidor över huvud taget kan ranka och indexeras.
Om canonical-logiken samtidigt klassar kategori-URL:erna som dubbletter av andra URL, och om produktlänkarna dessutom bara blir synliga efter JavaScript har laddats, då kapar man länkkraften från två håll samtidigt.
Vad tror vi händer då? Jo, först försvinner kontexten till Google och AI-crawlers, och sedan försvinner åtkomsten. Det är en ganska osexig kombination.
Vad GSC ofta visar
När man tittar i Search Console blir konsekvenserna ofta tydliga.
På sajten fanns omkring 8 000 URL:er i sitemapen. Länkrapporten visade 242 URL:er med mätbara internlänkar. Bland de mest internlänkade sidorna fanns kategorisidor, varumärkessidor och redaktionell innehåll (tänk magazine/blogg).
Produktsidorna, som är navet i e-handel, låg betydligt svagare till.
De starkaste produktsidorna låg runt 250-300 internlänkar, medan tusentals andra produkter knappt syntes i rapporten alls. Om de mest internlänkade URL:erna bara ligger på den nivån, bör man ställa nästa fråga som är, var befinner sig då majoriteten av produktsidorna?
Det här är ett problem som försämrar synligheten i både Google- och AI-sök. AI-sök förstärker bara konsekvenserna, eftersom retrieval-index inte är snällare än Google när det gäller svagt länkade sidor.
Vad det betyder i AI-sök
En AI-modell som ska svara på något i stil med “vilka [produktkategori] har [e-handlare]?” gör inte ett sitemap-anrop. Den hämtar från sitt retrieval-index det som är tillräckligt starkt representerat för att vara värt att nämna.
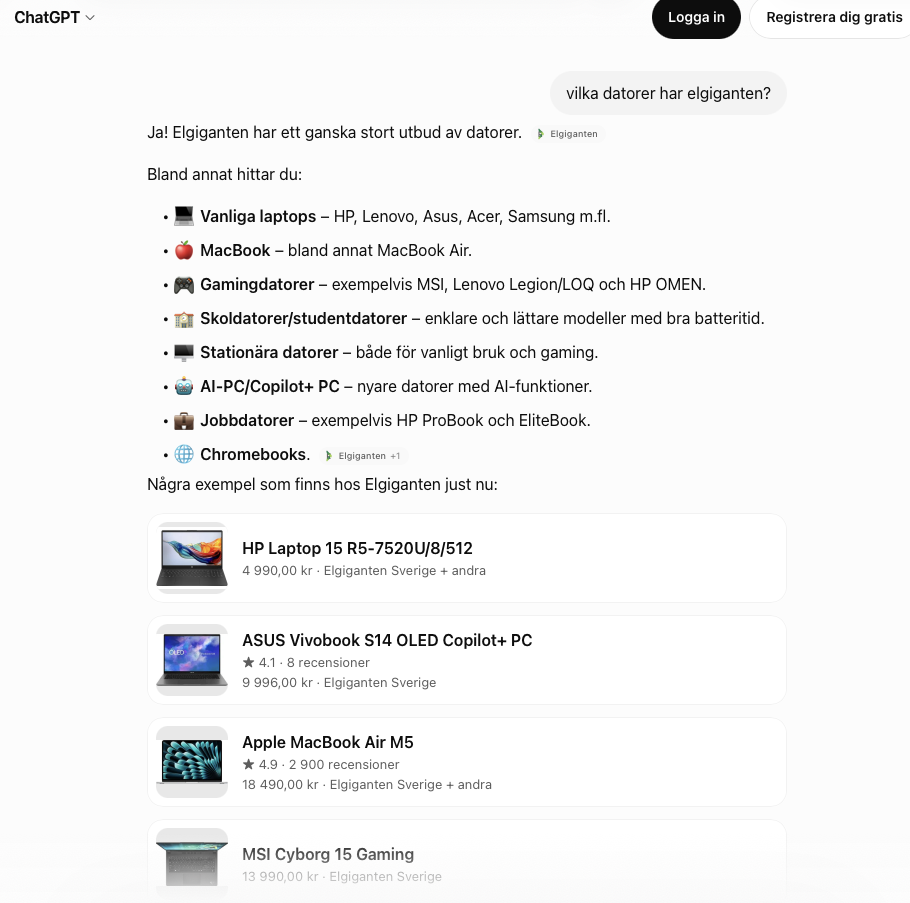
Det är där sajtstruktur börjar spela större roll än många tror.
I den sajt jag tittade på fanns dessutom ett slumpmässigt produkturval på kategorisidorna. Två webbläsarfönster med samma URL visade olika produkter. Det betyder att sidan inte är deterministisk.
För en crawler innebär det att den bara ser delar av innehållet av redan begränsad initial rendering. Nästa crawl visar något annat. Det gör att helheten blir otydlig och att det viktigaste innehållet riskerar att få mindre uppmärksamhet.
En produkt som en AI-crawler hittar ofta har större chans att synas än en produkt som den sällan eller aldrig hittar. Det är därför många e-handlare, även miljardbolag, behöver extern kompetens inom teknisk SEO för att vara rustad mot framtidens sök.
Diagnosen först
Det första steget är att förstå vilket problem man faktiskt har.
Om innehållet är beorende av JavaScript laddas in, och aldrig finns i server-renderad HTML är det ett renderingsproblem. Då kan SSR eller hybridsrendering vara rätt väg, men det kräver utvecklingsresurser.
Om innehållet går att rendera på servern men inte nås via riktiga <a href>-länkar är det ett internlänkningsproblem. Då behöver man riktiga paginerade URL:er som komplement till “Visa fler”-lösningen. Det är ofta en billigare fix och löser en stor del av discovery-problemet utan att man måste bygga om hela arkitekturen.
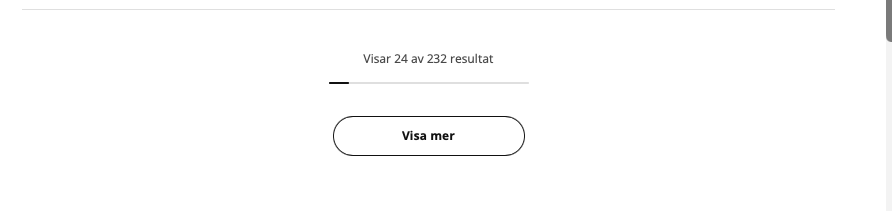
Screenshot på IKEAs setup för paginering på kategorisidor
Om canonical-strukturen och internlänkningslogiken drar åt olika håll är det ett auktoritetsproblem. Då måste man bestämma vilken URL som ska vara kanonisk och också bära internlänkkraften.
Det är tre olika problem som behöver tre olika typer av lösningar.
Så testar du det i praktiken
Renderingsfrågan går att testa med curl och grep. Det tar inte lång tid.
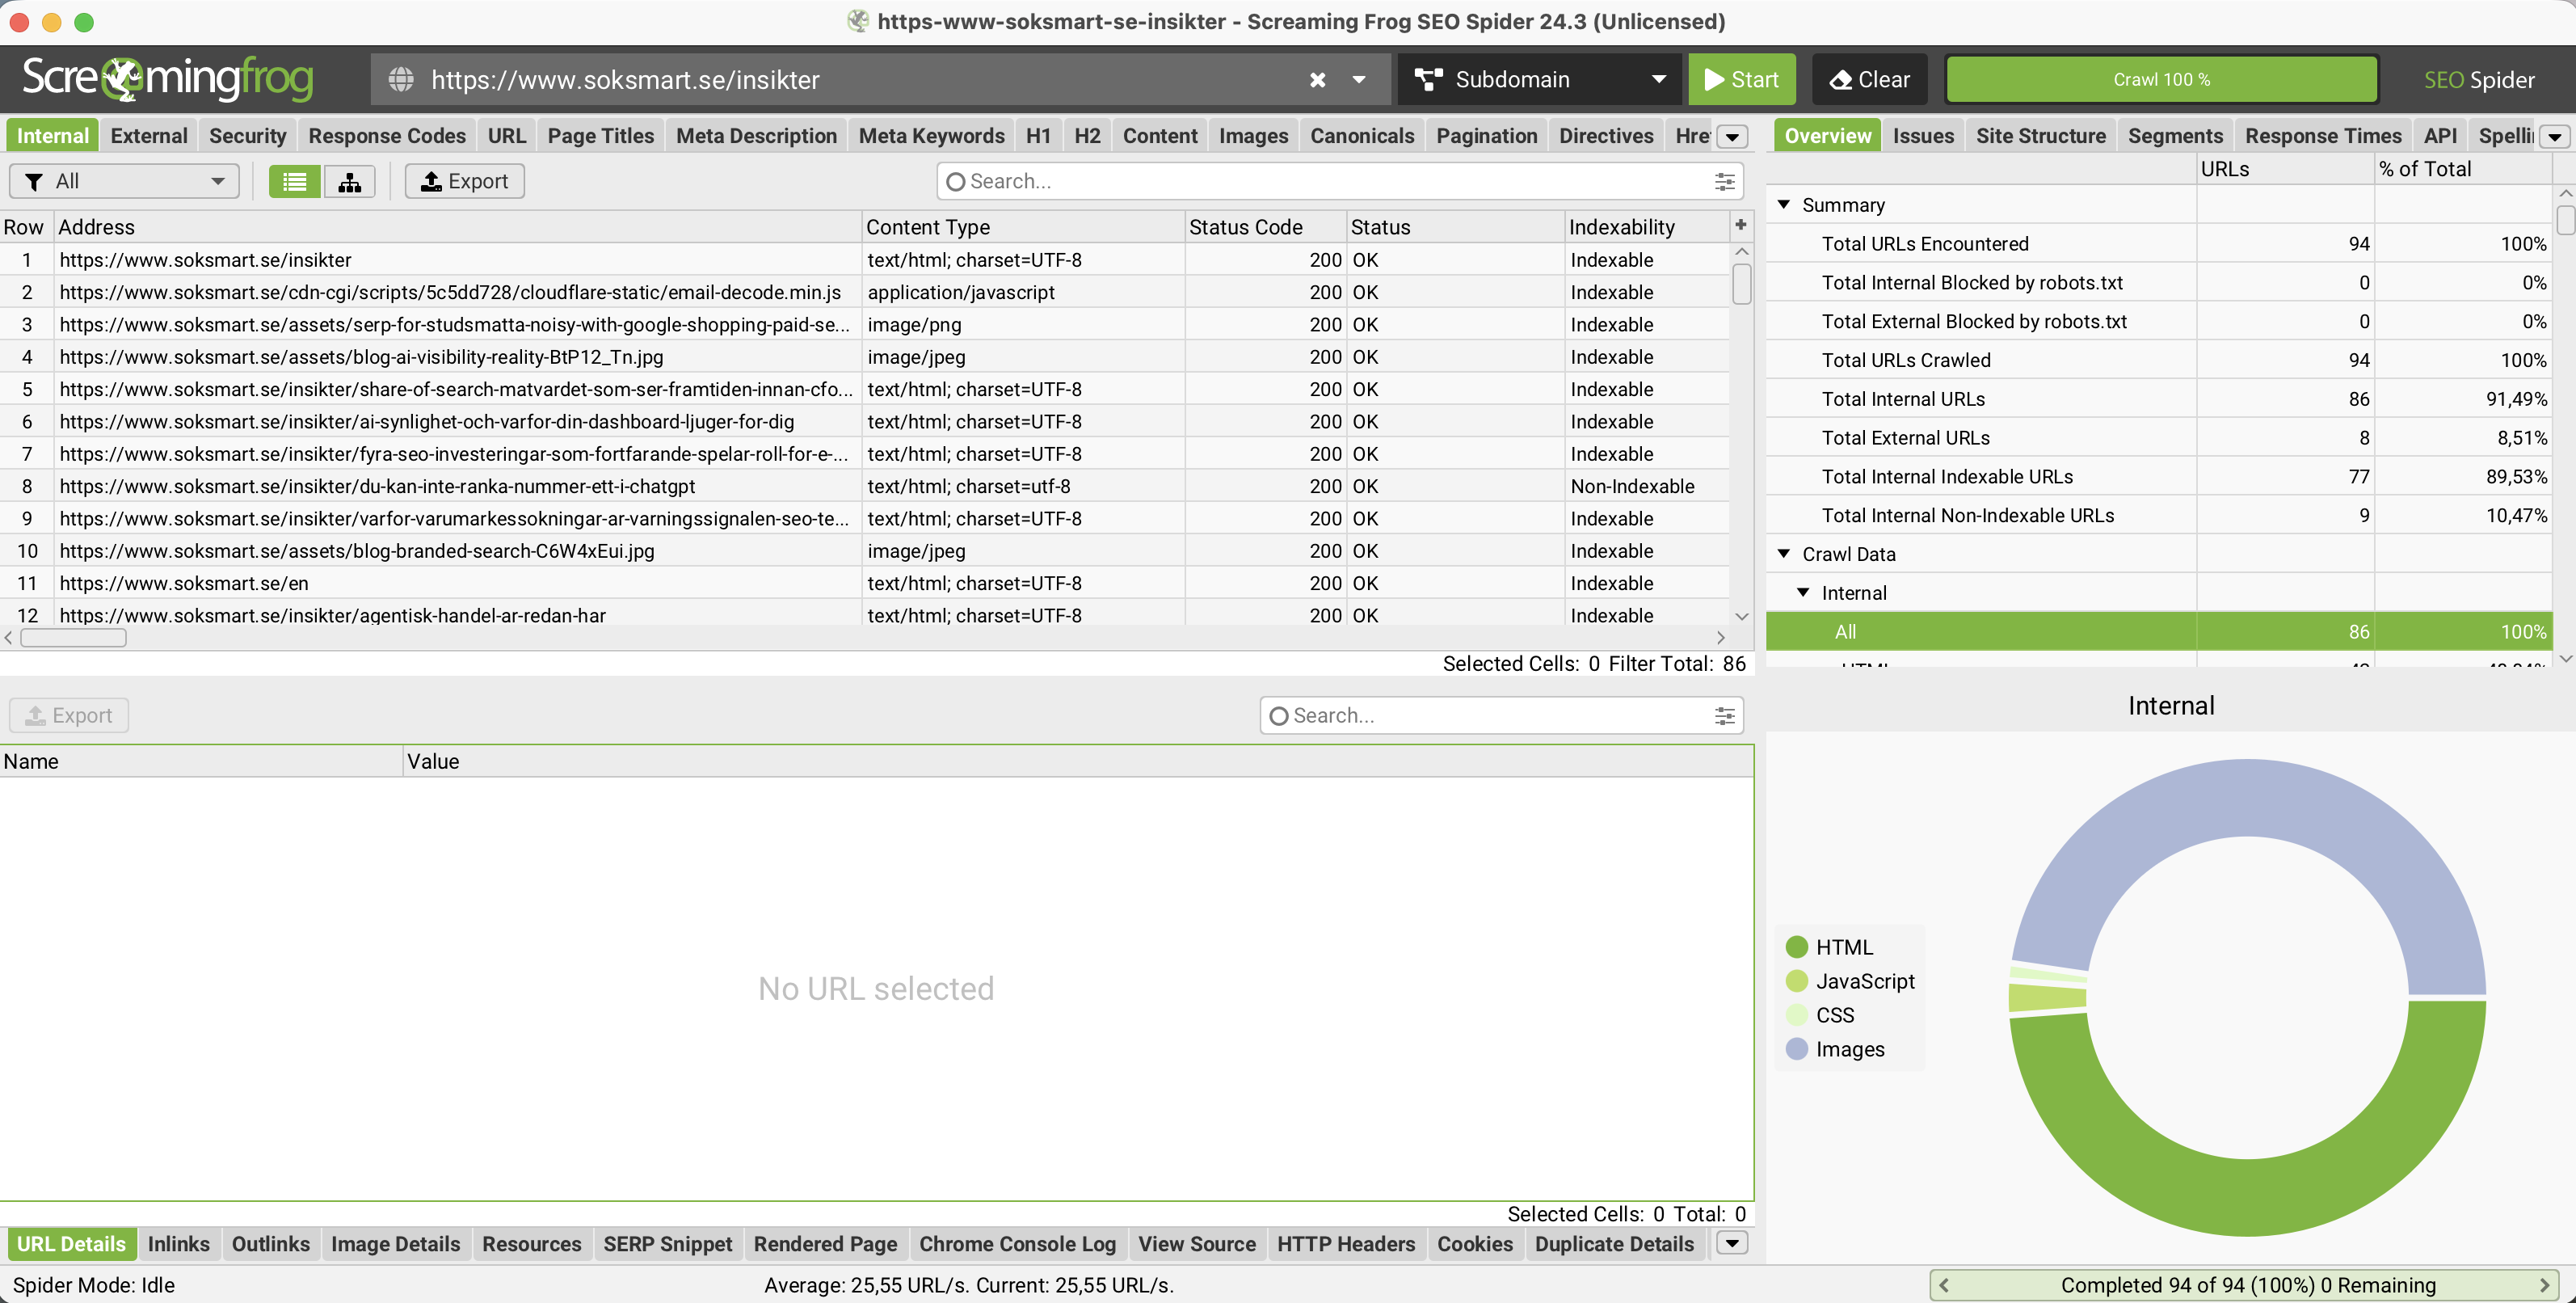
Internlänkningsproblemet går att testa genom att köra URL i Screaming Frog (finns inget bättre tekniskt SEO-verktyg än detta):
- Kör URL-lista i text-only-läge och i JavaScript-renderingsläge
- Exportera “Unique Inlinks” per produkt-URL
- Jämför skillnaden mellan de två körningarna, de visar i praktiken länkgrafen som en JS-renderande crawler ser jämfört med en icke-renderande crawler
Det är den siffran och diagnosen du briefar utvecklingsteam eller plattformsleverantör med.
För 2026 räcker det inte att vara indexerad, dina viktiga sidor behöver vara citerbara.
Det som spelar roll
När man landar i det här märker man att frågan inte egentligen handlar om JavaScript. Den handlar om om sajtens viktigaste ytor går att hitta, förstå och återanvända i ett system som är mycket mer selektivt än Google.
- Det kräver en intern länkstruktur som fungerar även utan klick
- Det kräver server-renderat innehåll där det måste vara navigerbart
- Det kräver en canonical-logik som hänger ihop med hur länkkraften ska flöda
Detta är ofta slarvigt gjort hos många svenska e-handlare.
Ställer man ihop det med min förra artikel om att kundrecensioner hämtas via tredjepartsverktyg, är sannolikheten hög att de varken hittas eller förstås av Google (och AI) blir bilden tvådelad.
Först: finns innehållet där crawlern tittar, eller bara i det webbläsaren bygger ihop efteråt?
Sedan, om svaret är ja: väger sidan den ligger på tillräckligt mycket för att vara värd att citera? Båda måste vara sanna. Den första utan den andra ger dig en sida som är tekniskt korrekt, men praktiskt osynlig.
Och just därför blir det här en så bra skillnad att börja med: inte om sidan är “AI-ready” i marknadsföringsmening, utan om den faktiskt går att läsa, nå och citera i det lager där synligheten nu avgörs.
Det är där ribban borde ligga.
Källor
Om du vill ha någon som säger att allt går bra finns det gott om sådana.
Om du vill ha någon som hittar flaskhalsen och löser den, då är det mer min gata.
Boka ett samtal med mig