AI-sök
ChatGPT, Gemini och Claude har redan en åsikt om dig – innan du ens promptat
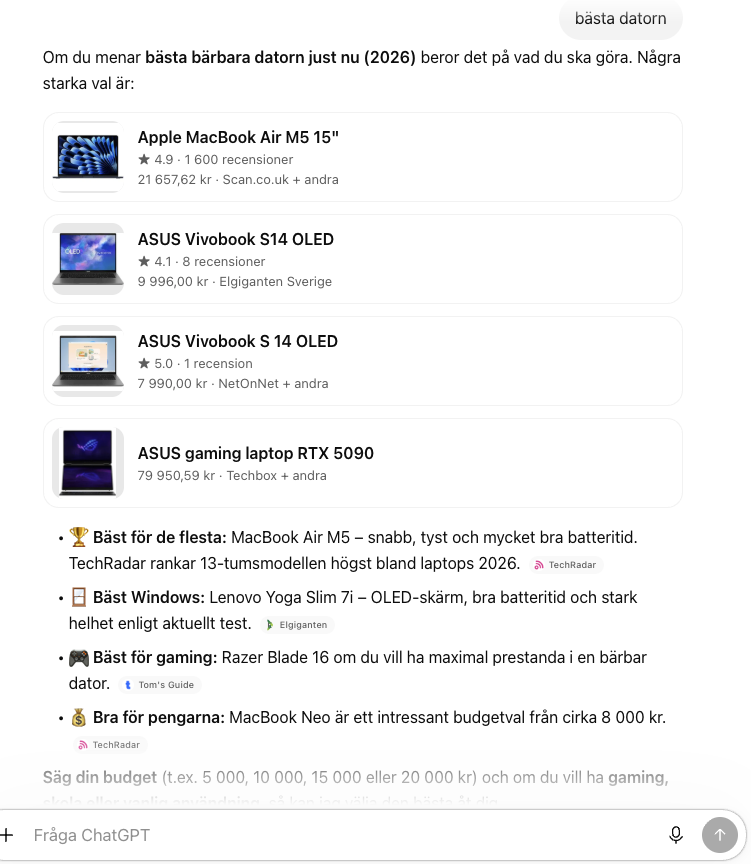
Webben kryllar av företag som återvinner samma generiska råd om hur man blir citerad i ChatGPT eller syns i AI-sök. Det är väldigt få som börjar i andra änden, med hur språkmodeller fungerar och vad det innebär för arbetet i ett AI-drivet söklandskap. Det är synd, för språkmodeller ger oss inte samma insyn som Google. Här finns ingen Search Console som vänligt berättar vad som gick snett.
Sanningen om hur språkmodeller fungerar i AI-sök
AI-sök är inte en sökmotor. Det är ett tolkande lager ovanpå en sökmotor. I stället för att möta sökresultaten direkt möter du en artig liten mellanhand som läser dem åt dig, sammanfattar dem och rekommenderar ett urval – i en ordning som modellen själv bestämmer.
Glöm TikTok-kändisarna. Den nya influencern i din marknadsföring är språkmodellen. Enligt Capgemini Research Institute använder 58 procent av konsumenterna redan AI-verktyg i stället för traditionella sökmotorer när de undersöker ett köp, jämfört med 25 procent två år tidigare. Modellen kan se Googles tio främsta resultat och ändå välja nummer nio som sin viktigaste källa och nummer tre som sin näst viktigaste. Det valet är inte slumpmässigt.
Det är språkmodellens uppfattning, känsla och fördom om ditt varumärke, omsatta i en ranking som ingen av oss ser.
Två sorters bias avgör om du ens syns
För att förstå varför behöver vi skilja på två saker som ofta klumpas ihop: vad modellen redan tycker om dig och vad som händer när den uppfattningen möter sökresultaten.
Primary bias - åsikten modellen redan bildat
Redan innan den gör en enda sökning har modellen en uppfattning om ditt varumärke. Den formas i två steg:
- Förträningen (pre-training): Modellen läser praktiskt taget hela det öppna internet. Allt som skrivits om ditt varumärke, dina produkter, din bransch, om du är bra eller dålig på det du gör.
- Efterträningen (post-training): Modellen finjusteras, bland annat genom förstärksinlärning med mänsklig återkoppling. Målet är att anpassa den till mänskliga värderingar och göra den till en “trygg och hjälpsam” assistent.
Det andra steget är inte neutralt. Forskning på instruktionstränade modeller visar att de kan uppvisa mer bias. Samma process som gör en modell “säker och hjälpsam” kan alltså förstärka vissa fördomar i stället för att sudda ut dem.
Den australiensiske SEO-veteranen Dan Petrovic har byggt en metod för att kartlägga hur språkmodeller uppfattar varumärken. Han kallar fenomenet primary bias: modellens inneboende förtroende, eller misstro, för en entitet innan någon sökning eller grounding (förankring i externa källor) ens har skett. Modellens magkänsla, om man nu får tillskriva en hög med parametrar en sådan.
Genom storskaliga, dubbelriktade frågeanalyser har han visat att varje modell bär på en egen, mätbar världsbild av varumärken. Vissa gynnas systematiskt medan andra missgynnas, oavsett vad som står i dagens sökresultat. I hans tester med Gemini var kinesiska varumärken exempelvis sällan top of mind.
Secondary bias - när fördomen möter sökresultaten
Primary bias handlar om det som redan finns inbyggt i modellen. Secondary bias uppstår när den uppfattningen möter de källor som modellen hämtar in för en viss fråga, det som brukar kallas grounding.
Därför går AEO inte att reducera till en teknisk checklista. Om modellen redan har en negativ primary bias mot ditt varumärke kan den utelämna dig helt, även när du finns bland de hämtade källorna. Det är också därför jag tycker att ren citeringsspårning är ganska meningslös. Gillar modellen dig sedan tidigare kan du hamna högst upp trots att din källa ligger sist i underlaget, helt enkelt på grund av det modellen redan har lärt sig om dig.
Det är spelet i ett nötskal. Du optimerar inte bara för synlighet i sökresultaten. Du försöker också påverka en åsikt som modellen bildade långt innan du ens kom in i rummet. Lite som att försöka vinna över en svärförälder som redan har läst recensionerna.
Grounding, citering och omnämnande är inte samma sak
Tre begrepp blandas ständigt ihop i diskussionen om AI-synlighet. Skillnaden mellan dem avgör vad du faktiskt bör bry dig om.
- Grounding: Du levereras till modellen som en möjlig kandidat – en av källorna den hämtar in för att bygga sitt svar. Google beskriver grounding som förmågan att koppla modellens output till verifierbara källor. Det är däremot ingen garanti för att källan används.
- Citering: Modellen använder en av dina grounding-källor för att styrka ett specifikt påstående, oftast som en diskret referens eller länk i marginalen
- Omnämnande: Ditt varumärke förekommer i själva svarstexten, antingen som ren text eller med en länk. Den senare varianten är den riktiga fullträffen och samtidigt svårare att spåra.
Ett omnämnande med länk är det som egentligen betyder något när vi pratar om AI-synlighet. Sluta stirra dig blind på citeringsstatistik. En citering visar bara att du fanns med någonstans i konversationen. Du kan ha citerats i det första svaret och varit spårlöst borta två promptar senare, trots att samtalet fortsatte i ytterligare tio. Vad säger den första citeringen då? Inte särskilt mycket. De nada.
Ett omnämnande, särskilt med en länk till din produkt eller bild, tyder däremot på att modellen behandlar dig som en etablerad entitet som den känner igen och litar på, inte som en källa den råkade snubbla över just den här gången.
Så väljer modellerna sina källor
Här kommer en obekväm sanning som punkterar en stor del av AEO-hypen och dess dyrt paketerade PDF-guider: språkmodeller crawlar i regel inte hela webben i realtid när de svarar. De söker i befintliga index som redan har byggts av någon annan:
- ChatGPT har numera en egen sökrobot, men bygger fortfarande delar av sin sökfunktion på ett indexsamarbete med Bing
- Gemini är direkt kopplat till Googles aktuella sökindex genom det som Google kallar ”Grounding with Google Search”
- Claude tycks använda Brave Search. Det är inte något som har bekräftats officiellt, men som har dokumenterats via Anthropics lista över underleverantörer
Om du inte är indexerad i de här systemen har modellerna små möjligheter att ens överväga dig. Där faller en stor del av AEO-hypen platt. Ingen mängd ”AI-optimerat” innehåll hjälper om du inte först klarar grundläggande crawlbarhet och indexering hos Bing eller Google. Punkt.
Varför spam i stor skala inte längre fungerar
Vi som har arbetat med sök i några år har sett vågen av massproducerade AI-slops. Företag pumpar ut mängder av AI-genererade artiklar utan vare sig substans eller strategi. Resonemanget låter först logiskt: Google har i praktiken en kopia av stora delar av den öppna webben, och Gemini tränas på material från just den webben. Ju större närvaro, desto fler möjliga kopplingar i modellens neurala nätverk.
Men det är inte hela bilden. De ledande modellerna från Anthropic, Google och OpenAI har redan lärt sig språket. Nu ligger mycket av arbetet i att välja och förädla träningsdata. Labben lägger enorma summor på att hitta de bästa exemplen i hav av mediokert material (inklusive AI-slop), i stället för att bara hälla in mer av allt. Forskning visar att aggressiv filtrering kan bevara modellprestandan med tio gånger mindre data. Kvalitet slår kvantitet. Med råge.
Det innebär att storskaligt spam, inklusive programmatiskt innehåll, inte längre är en trovärdig väg till AI-synlighet. Modellutvecklarna försöker aktivt filtrera bort just den typen av material när de bygger sina träningsdataset. Du skapar inte en positiv primary bias genom volym. Du gör det genom kvalitet, konsekvens och genom att bli någon som modellen har anledning att lita på.
Hur påverkar du då träningsdata?
Det uppenbara svaret, som redan ekar över hela LinkedIn är att “skapa bra, högkvalitativt innehåll” och “jobbar mer med PR”. Ja, detta är sant, men det är ofullständigt.
Positionering i AI-sök är ett av de viktigaste marknadsföringsinitiativen för e-handlare. Det som särskiljer ett varumärke i ett mättat digitalt landskap är egna insikter och egen data, inte ännu en portion mikrovärmd branschprat.
Men PR är bara en kanal. Det som fastnar avgörs av vad du fyller den med. Och det är här många företag missar målet redan i sin vanliga marknadsföring, långt innan AI-sök kommer in i bilden: positioneringen.
Om ett företag inte kan förklara varför kunden ska välja just det, och inte konkurrenten bredvid, varför skulle en språkmodell kunna göra det åt dem?
Modellen lär sig inte positionering ur den tomma luften. Den lär sig genom återkommande mönster. Samma särskiljande budskap, konsekvent upprepat i tillräckligt många relevanta källor under tillräckligt lång tid. Generiskt PR-brus om att vara ”marknadsledande” och ”kundfokuserad” ger modellen exakt noll att särskilja dig med. Ett skarpt och konsekvent svar på frågan ”varför just ni?”, återkommande på webben och i sociala medier, ger den betydligt mer.
Vad det betyder för dig
Före retrievability och före staplarna i din dashboard finns en uppfattning som modellen redan har bildat om dig, långt innan du publicerade ditt senaste blogginlägg. Denna bias är också det lager som du som e-handelsföretag faktiskt kan arbeta långsiktigt för att påverka.
Det här är inget ”pump and done”-projekt. Du behöver vara konsekvent i din positionering och värd att minnas, på tillräckligt många relevanta platser och under tillräckligt lång tid. Med andra ord… ungefär det arbete som alltid har byggt starka varumärken. AI-sök har bara gjort det betydligt svårare att fejka.
Källor
- DEJAN — Primary Bias & Selection Rate in AI Search
- DEJAN — Bias and Prejudice in AI Search
- ipullrank — SEO Week 2025: Dan Petrovic, Beyond Rank Tracking
- Search Engine Land — Dan Petrovic: How to withstand algorithm updates and optimize for AI search
- "Global is Good, Local is Bad?": Understanding Brand Bias in LLMs (EMNLP 2024)
- Instructed to Bias: Instruction-Tuned Language Models Exhibit Emergent Cognitive Bias
- Google AI for Developers — Grounding with Google Search
- Search Atlas — AI Citations vs Mentions
- TechCrunch — Anthropic appears to be using Brave to power web searches for its Claude chatbot
- Toloka — Foundation model training data: how frontier labs build pre-training datasets at scale
- Capgemini Research Institute — consumer trends report (58% stat)
Om du vill ha någon som säger att allt går bra finns det gott om sådana.
Om du vill ha någon som hittar flaskhalsen och löser den, då är det mer min gata.
Boka ett samtal med mig