AI-sök
Du kan inte ranka #1 i ChatGPT
Varför AI-synlighet blivit marknadsföringens mest missförstådda (läs: overhypade) mätvärde
Du kan inte ranka #1 i ChatGPT. Jag vet, det låter som en no-brainer om du jobbat med sök ett tag. Men efter min tid som SEO-chef på Jollyroom, och senaste året som konsult åt miljardbolag, har jag tappat räkningen på hur många briefingar som ändå landar precis där.
Jag vill vara tydlig med att det inte är marknads- eller e-handelschefer som är dumma. Det är snarare att min bransch sålt in AI-synlighet med exakt samma språk som vi använde om Google: ranking, Share of Voice, position.
Det beslutsfattare bör veta är att språkmodeller inte fungerar som Google. Det spelar roll mer än de flesta verktygsleverantörer vill erkänna.
Vi har blivit bortskämda
I tre decennier har SEO gått att observera. Sök efter samma sak som en kollega, jämför resultat, dra samma slutsats. Google har aldrig varit transparent, men stabilt nog för att ge oss en gemensam verklighet.
Den vanan följde rakt in i AI-sök. Branschen började prata om AI-synlighet och Share of Voice i ChatGPT innan någon frågade om det här ens är rätt frågor att ställa?
En språkmodell är inte en sökmotor
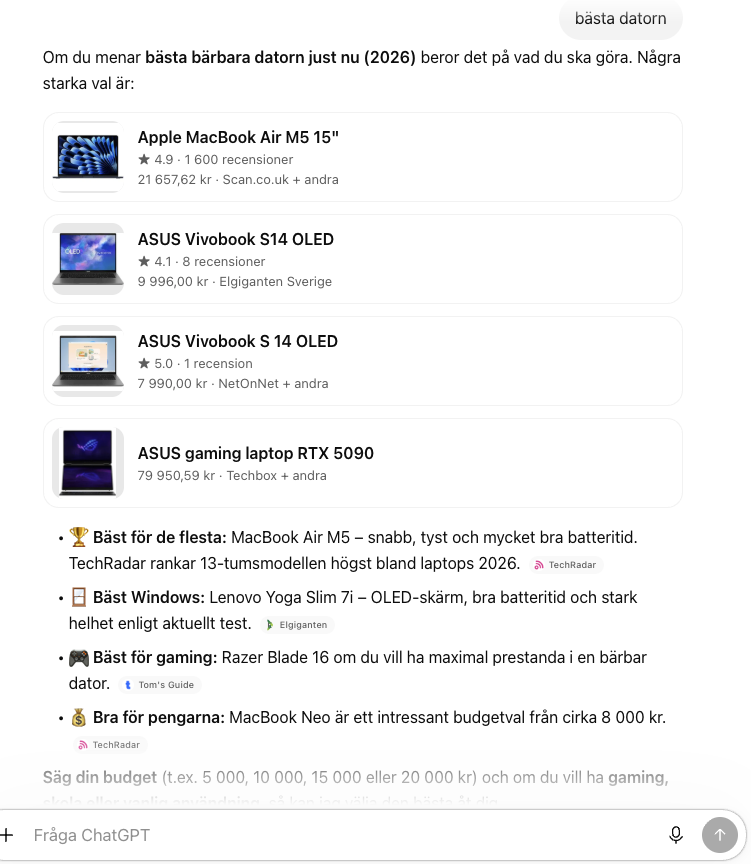
När du använder Googles sökruta får du tillbaka en lista med dokument. Du kan peka på ett och säga ”det här rankar högre än det där”. En språkmodell gör ingenting sådant. Den genererar ett svar som är vägt samman av sannolikheter, kontext och interna representationer du aldrig får se. Det är inte en teknisk detalj. Det är hela problemet.
Ahrefs har visat att AI-svar ofta citerar källor som inte ens finns bland Googles topplaceringar för samma fråga. Suganthan Mohanadasan gick ett steg längre och analyserade ChatGPT:s nätverkstrafik: en källa kan hämtas, användas och citeras. Det är tre olika saker, som de flesta verktyg mäter som om de vore en.
Så när någon frågar ”hur syns vi i ChatGPT” är det första jag frågar tillbaka: syns i vad, exakt? Hämtad, använd eller citerad? De flesta vet inte skillnaden. De flesta verktyg berättar det inte heller.
Att mäta är lätt
Att samla in data är i dag trivialt. Skicka tusen prompts till fem modeller, logga svaren, klart. Det svåra kommer efteråt.
Om ett verktyg säger att ditt varumärke nämns i 38 % av testade prompts, låter det som en objektiv sanning. Det är snarare en sanning om just det promptbiblioteket. Alltså, vem som skrev frågorna, hur de formulerades, vilka modeller som svarade. Ingen opinionsundersökning skulle våga påstå att den pratat med ”befolkningen”. Den redovisar urval, metod eller felmarginal. Jag har inte stött på något AI-synlighetsverktyg som visar den transparensen. En dashboard med en procentsats ser objektiv ut oavsett hur skakigt urvalet bakom är.
Läs också: AI-synlighet och varför din dashboard ljuger för dig
Jag skickade samma prompt om och om igen
Jag körde ”bästa barnvagn” i ChatGPT 100 gånger i rad i inkognito och med VPN, för att inga personliga data eller tidigare konversationer skulle färga svaret. Medvetet snävt. En prompt, en plattform. Inget Claude, ingen Gemini, ingen Perplexity.
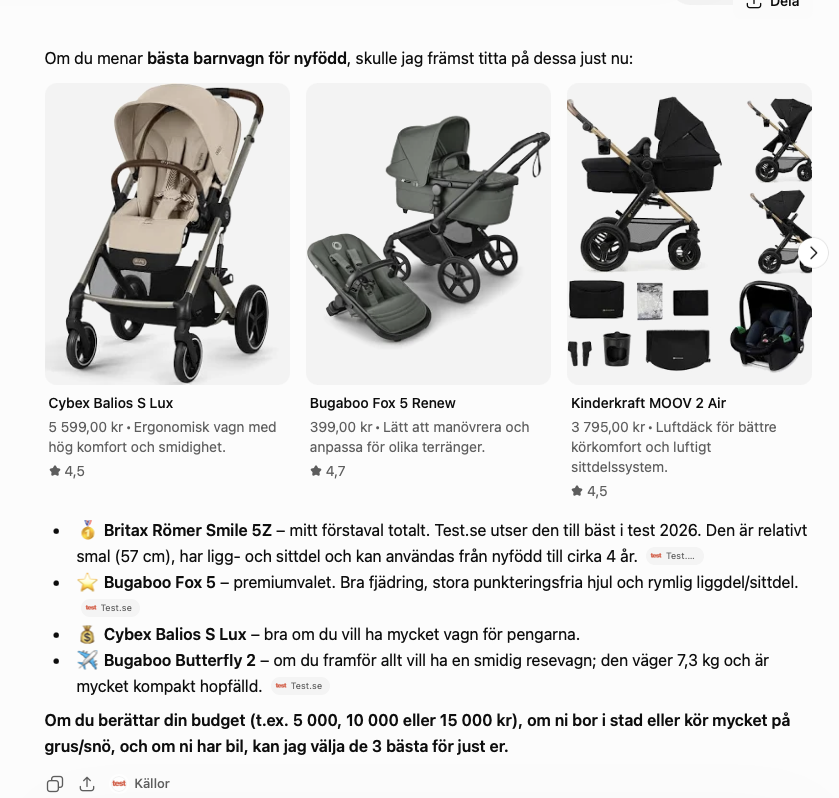
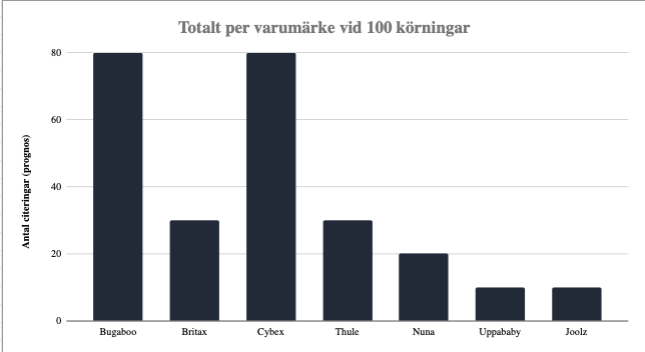
På varumärkesnivå var svaret förvånansvärt stabilt: Bugaboo, Cybex och Britax låg i topp 3 i så gott som varje körning. Men i en närmare genomgång av körningarna, ner på vilken specifik produkt från respektive varumärke som lyftes fram, försvann stabiliteten. Samma varumärken, andra modeller, andra argument, körning efter körning.
Däremot skulle aldrig en vanlig användare köra testet så här rent. De skriver ”bästa barnvagn” i ett ChatGPT som redan minns deras tidigare konversationer och ger ett svar kurerat efter deras preferenser.
Och det här är resultatet för varumärken med enormt mycket innehåll och omnämnanden redan online. Om variationen är så här tydlig under de förutsättningarna, fundera på vad som händer när tusen olika prompts, fem modeller och tusentals mindre etablerade varumärken ska representera en hel marknad.
Se nedan för resultatet av det experimentet:
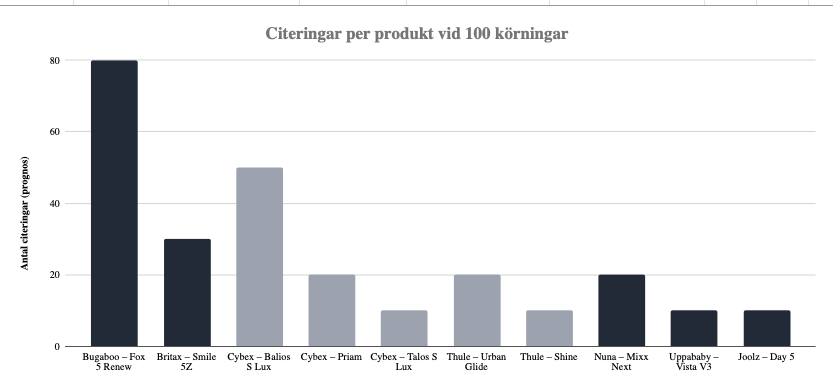
- Bugaboo: Fox 5 Renew nämndes 80 gånger (30,77 % av total andel av citeringar)
- Britax: Smile 5Z nämndes 30 gånger (11,54 % av total andel av citeringar)
- Cybex: Balios S Lux nämndes 50 gånger (19,23 % av total andel av citeringar)
- Cybex: Priam nämndes 20 gånger (7,69 % av total andel av citeringar)
- Cybex: Talos S Lux nämndes 10 gånger (3,85 % av total andel av citeringar)
- Thule: Urban Glide nämndes 20 gånger (7,69 % av total andel av citeringar)
- Thule: Shine nämndes 10 gånger (3,85 % av total andel av citeringar)
- Nuna: Mixx Next nämndes 20 gånger (7,69 % av total andel av citeringar)
- Uppababy: Vista V3 nämndes 10 gånger (3,85 % av total andel av citeringar)
- Joolz: Day 5 nämndes 10 gånger (3,85 % av total andel av citeringar)
AI-synlighet är ett diagnostiskt mått
En ekonom följer inflation och räntor utan att tro att ett enda tal förklarar hela ekonomin. En läkare ställer inte diagnos på ett blodprov. Marknadsföring borde fungera likadant, men vi har en förkärlek för att göra varje nytt KPI till ett omsättningsbevis.
När en byrå lovar ”fyrtio procent mer AI-synlighet” låter det som ett affärsresultat.
Sanningen är att sälja AI-synlighet som ett affärsresultat påminner om att sälja en väderprognos och sen fakturera för solskenet. Prognosen är värdefull, absolut, den hjälper dig planera. Men det skapar inte vädret. På samma sätt kan AI-synlighet visa hur språkmodeller verkar uppfatta ditt innehåll. Den visar inte att någon köpte något.
Läs också: Hur Google och AI väljer vad som visas
Kolla hela kedjan
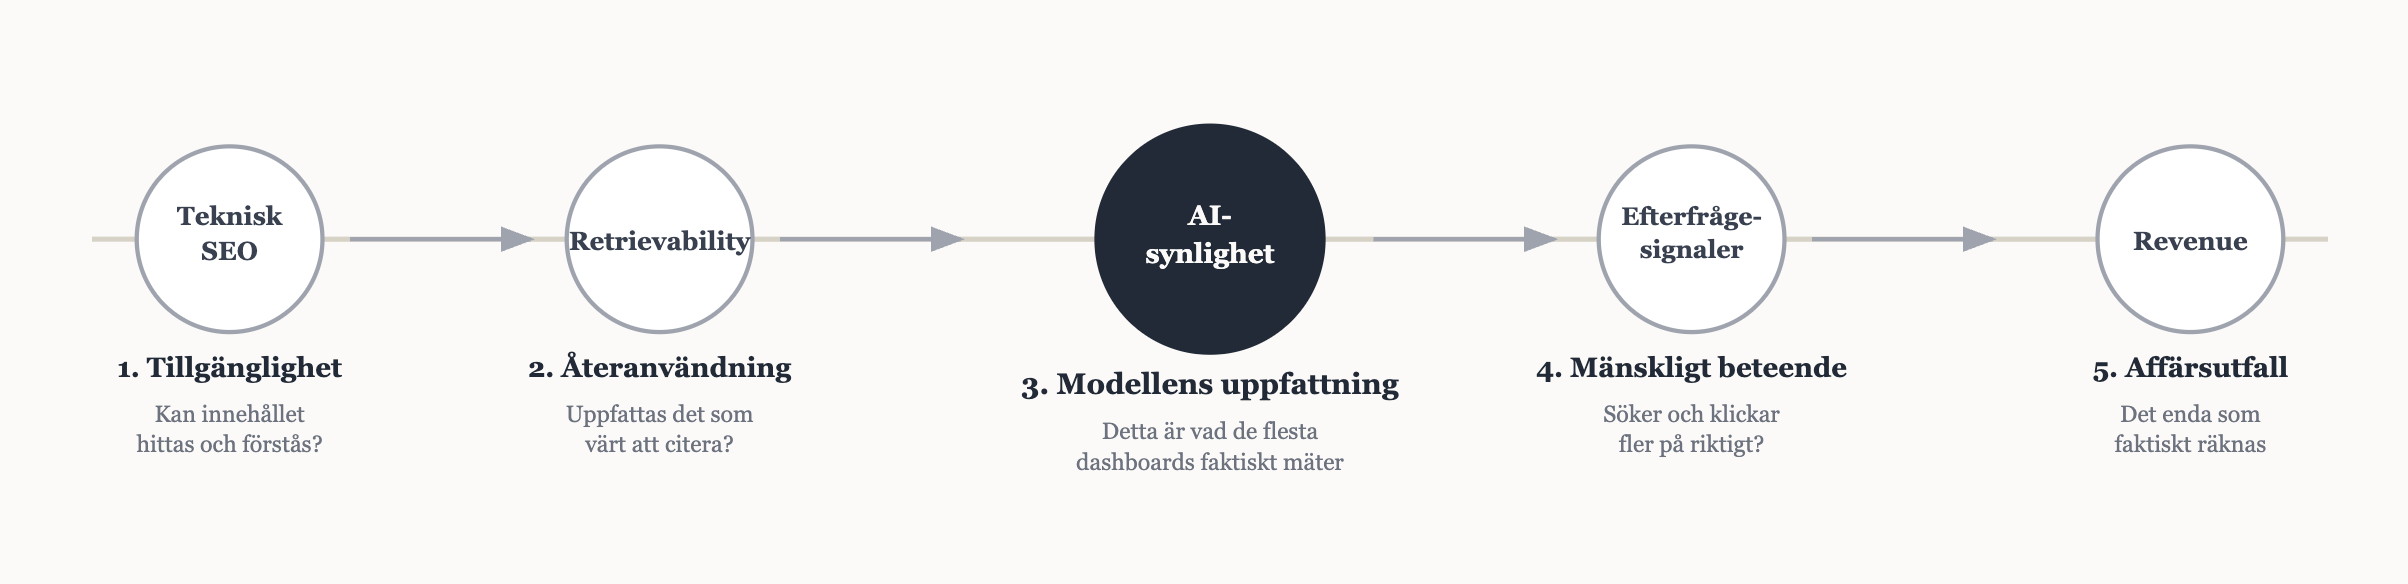
Det här är ramverket jag använder med kunder, och det är enkelt med flit:
- Teknisk SEO skapar förutsättningar för retrievability: kan innehållet överhuvudtaget hittas och förstås?
- Retrievability skapar förutsättningar för AI-synlighet: väljer modellen att nämna, citera eller referera till innehållet?
- AI-synlighet kan, tillsammans med annat, bidra till förändrade efterfrågesignaler: börjar fler söka på varumärket, klicka från AI-plattformar?
- Och först därefter syns effekten i affären: revenue, marginal, marknadsandel. Inget lager konkurrerar med de andra.
Problemet uppstår när ett lager får bära ett ansvar som hör hemma längre upp i kedjan. AI-synlighet är lager två. Den är inte lager tre, hur gärna en säljpitch än vill göra den till det.
Vad det betyder om du sitter på budgeten
Jag skulle inte avfärda AI-synlighet. Jag skulle heller inte göra den till ett KPI. Jag skulle behandla den som jag behandlar alla nya mätvärden: med nyfikenhet och en tydlig känsla för vad den kan säga.
Innan jag litade på en dashboard skulle jag fråga:
- Hur valdes prompterna, och hur representativa är de för riktiga användare?
- Hur mycket varierar resultaten mellan körningar?
- Hur ofta uppdateras promptbiblioteket?
- Kopplas något av det här till varumärkessök, AI-referrals eller faktiska affärsresultat, eller stannar det vid en procentsats i ett hörn av en rapport?
Det handlar inte om att vara misstänksam mot verktyget. Det handlar om att fråga vilken typ av beslut resultatet faktiskt orkar bära. Ju större investering ett mätvärde ska motivera, desto högre krav borde du ställa på underlaget bakom det.
Läs också: Varför AI-synlighet ännu inte är ett skäl att bygga om din SEO-budget
Vi vet mindre än vi tror
AI-sök förändras snabbare än nästan allt annat inom marknadsföring just nu. Jag hoppas att delar av den här texten känns daterade om två år, att OpenAI och Google blir mer transparenta, att vi får något som liknar en Search Console för AI.
Tills dess är den mest värdefulla egenskapen inte tvärsäkerhet. Det är metodologisk ödmjukhet.
Den största risken med AI-sök är att vi redan börjat fatta stora beslut som om vi visste allt.
Om du vill ha någon som säger att allt går bra finns det gott om sådana.
Om du vill ha någon som hittar flaskhalsen och löser den, då är det mer min gata.
Boka ett samtal med mig