AI-sök
Er bästa kundrecension finns kanske inte för Google (eller AI)
E-handlare som jobbar med “SEO och AI” investerar i innehåll som vissa crawlers sannolikt aldrig får se. Det är en miss jag ser gång på gång.
Det gäller särskilt sajter som kör tredjepartsverktyg för UGC, recensioner, produktinformation och annat dynamiskt innehåll. För kunden ser allt perfekt ut. Men under huven kan verkligheten vara en annan.
Testet är enkelt.
Högerklicka på en valfri landningssida, "Visa sidkälla", och sök (Ctrl+F) på en mening ur er bästa kundrecension.
Finns den där? Eller finns recensioonen bara när du inspekterar elementet, efter att sidan laddat klart?
Om det är det senare har du svaret. Innehållet hämtas sannolikt från en extern tjänst och injiceras client-side, via JavaScript och API-anrop, efter att servern redan skickat sin HTML. Det finns alltså inte i det servern levererar först, utan bara i det webbläsaren bygger ihop efteråt.
Är det automatiskt ett SEO-problem?
Nej. Google kan rendera JavaScript, det har de kunnat länge.
Men "kan" och "kommer alltid att göra det framgångsrikt, i tid, för just din sida" är två olika saker. Jag kan också springa en kilometer. Det betyder inte att man bör bygga sin tekniska arkitektur kring att jag gör det, varje gång, i tid.
Vad Google själva säger om detta
Google uppdaterade sin JavaScript SEO-dokumentation så sent som i december 2025, med vägledning specifikt om det här mönstret. Kanonisering (canonicals) och andra signaler kan bedömas två gånger:
- En gång på den råa HTML:en
- En gång efter rendering
Om dessa säger emot varandra är rekommendationen glasklar. Sätt de viktigaste signalerna i den ursprungliga, server-renderade HTML:en. Inte som en” efterhandspatchning” via JavaScript.
Det här är inte en hypotetisk risk någon SEO-konsult (jag) hittat på. Det är Google själva som skriver ner det… mycket sannolikt för att de ser det hända ute i verkligheten tillräckligt ofta för att behöva dokumentera det..
Så var kommer AI-crawlarna in?
Vercel mätte det här på sitt eget nätverk i december 2024, med över 1,3 miljarder månatliga anrop från AI-crawlers, motsvarande ungefär 28 % av Googlebots volym på deras plattform.
Resultatet:
- ChatGPT hämtade JavaScript-filer i 11,5 % av anropen
- Claude i 23,84 %
Men ingen av dem, alltså, GPTBot, ChatGPT-User, ClaudeBot eller PerplexityBot körde JavaScripten de hämtade. De läser det som kommer i det första svaret från servern. Punkt.
Innehåll som bara finns efter en fullständig rendercykel är inte bara fördröjt för de här crawlarna, det är osynligt.
"Men vi har ju schema markup?"
Bra. Behåll den.
Men den räddar dig inte här. Det som länge varit en magkänsla finns det nu faktiskt siffror på.
Ahrefs spårade 1 885 sidor som fick JSON-LD-markup tillagd, matchade mot 12 000 kontrollsidor, över tre AI-plattformar.
TL;DR det gav ingen mätbar uplift i AI-citeringar på ChatGPT eller Google AI Mode. Google AI Overviews gick ner 4,6 %, statistiskt signifikant.
Varför, tänker du säkert? Schema markup beskriver innehållet. Det ersätter det inte.
En LLM som ska citera eller sammanfatta plockar från prosa, inte från en @type: Product-nod. Google har dessutom själva varit tydliga i flera år att strukturerad data ska matcha det synliga innehållet. Det är INTE en genväg förbi att göra innehållet tillgängligt.
Testet: två metoder, en produktsida, samma slutsats
Det enda du behöver för att diagnostisera detta är ett tangentbord, en datormus och din dator.
Jag körde det på en produktsida med många recensioner hos Cervera för att visa hur det ser ut i praktiken. En sidenote: jag uppelver att Cervera är duktiga överlag med sin SEO, och det är tydligt att de investerar i det, men jag vill också visa dig att även miljardbolag kan brista på det tekniska.
Metod 1 — en site:-sökning
Ta en unik textsträng ur en kundrecension på en produktsida. Sök på site:dinsajt.se "exakt textsträng".
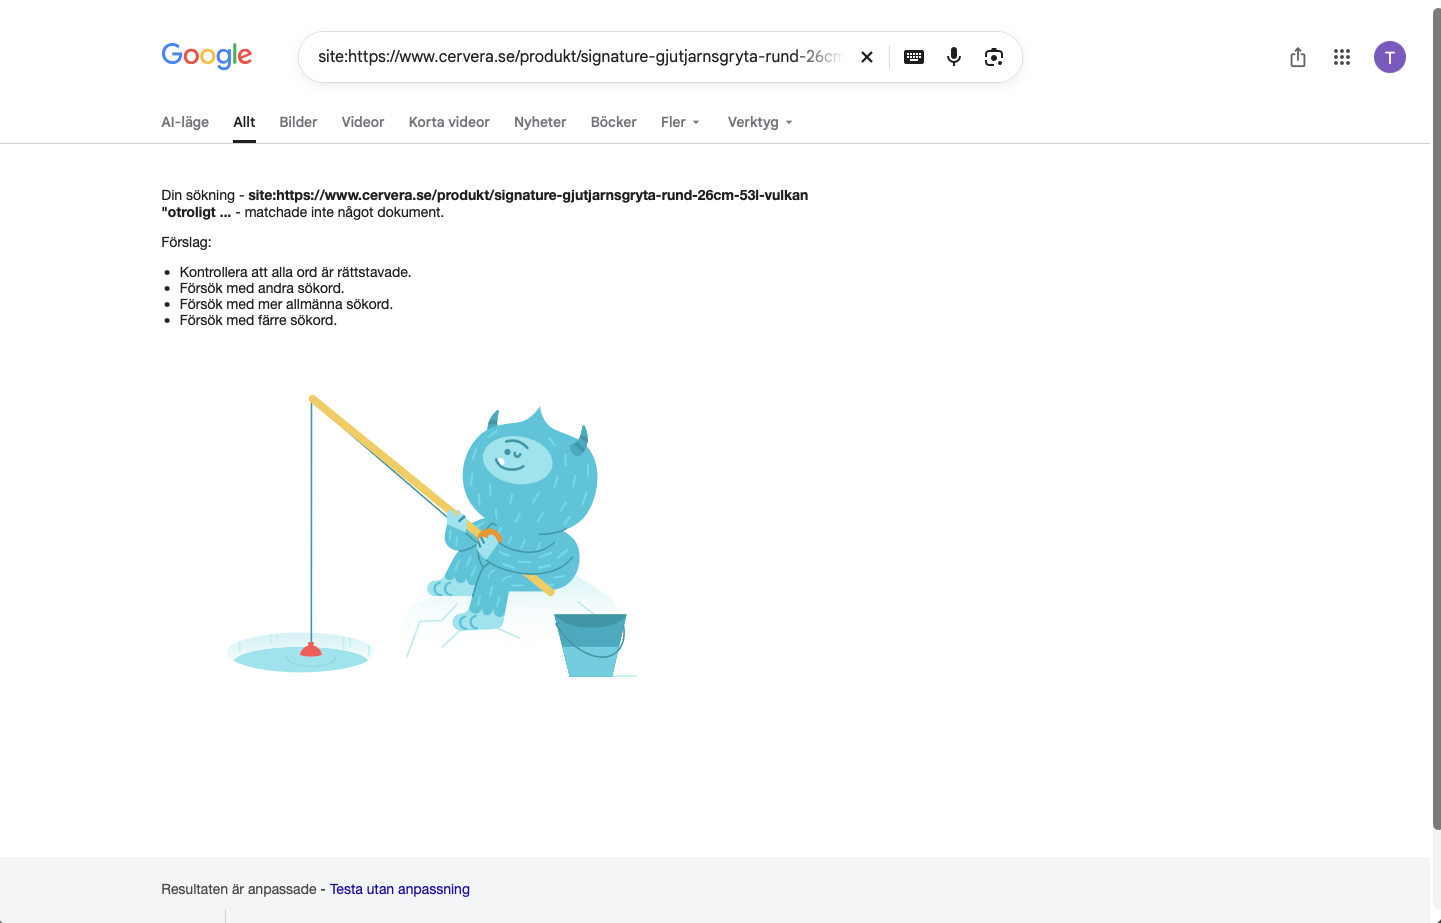
Recensionen "Otroligt snygg. Känns gedigen och bra." ligger synlig på sidan för varje besökare på en av Cerveras gjutjärnsgrytor.
"Matchade inte något dokument." Recensionen finns på sidan, för besökaren. Den finns inte hos Google, i alla fall inte indexerad med den texten.
En liten brasklapp här. En site:-sökning är ett bra första signal. Google har själva varit tydliga med det, bland annat har John Mueller sagt rakt ut att "the site: query is not meant to be used for diagnostic purposes", att resultaten är optimerade för hastighet snarare än att vara heltäckande.
Så en enstaka nollträff bevisar inte allt på egen hand. Därför kör jag metod 2 också, och i en fullständig utredning bör man väga in ännu fler signaler (Search Console, testfetchar med olika user-agents, med mera) innan du drar en slutgiltig slutsats. Här räcker de här två för att visa principen.
Metod 2 — källkoden, för att bekräfta varför
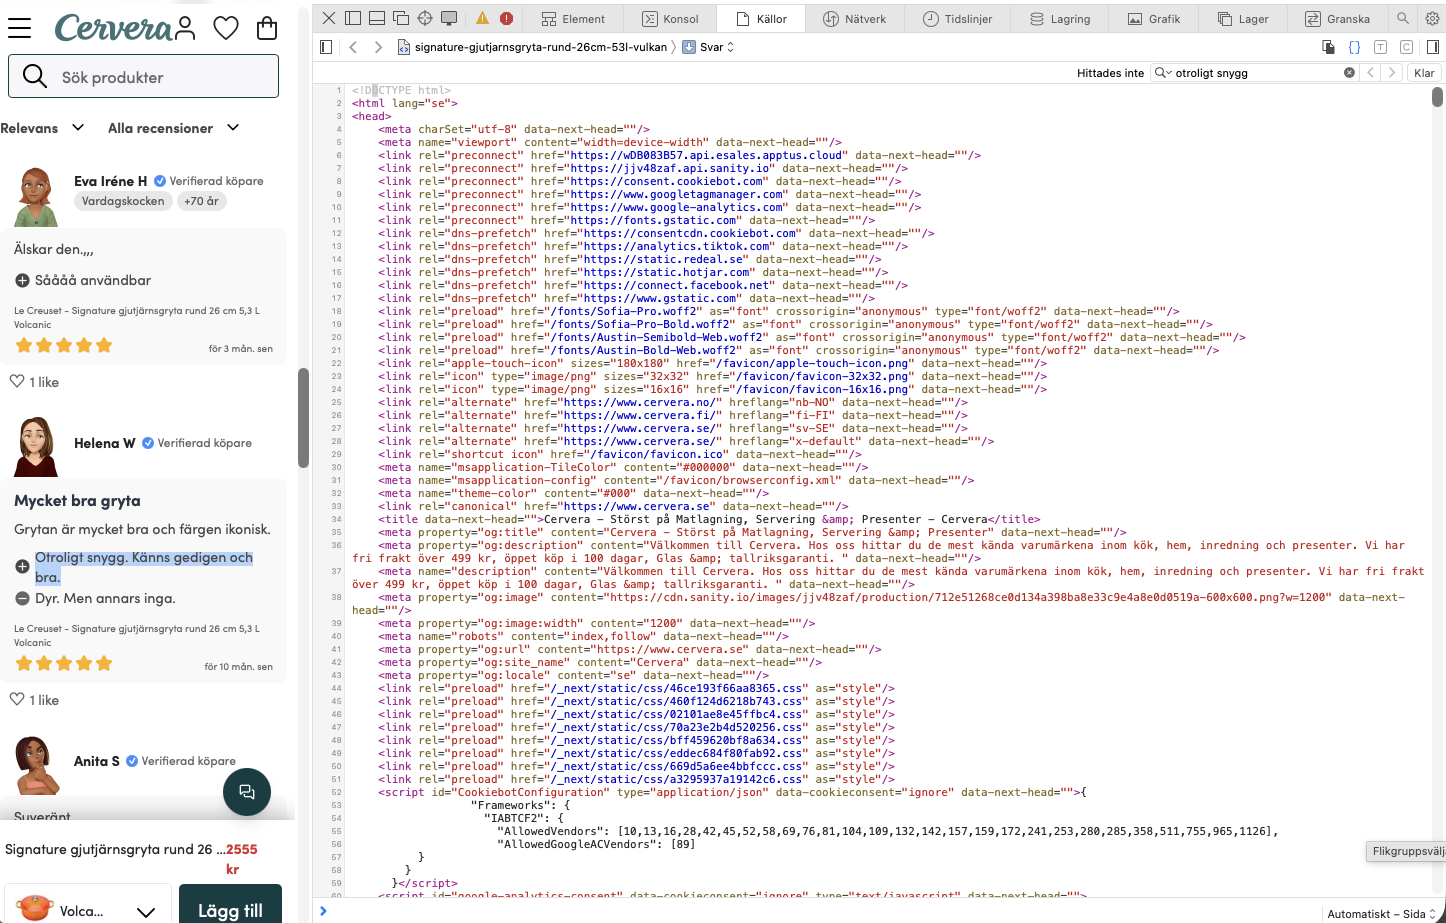
Öppna DevTools → Källor (eller Ctrl+U för klassisk Visa sidkälla) på samma produktsida. Sök på samma textsträng, "otroligt snygg".
I screenshot ser du "Hittades inte."
Recensionen syns i vänsterpanelen, för mig som besökare, samtidigt som sökningen i källkoden till höger inte hittar ett spår av den.
Nu vet vi varför site:-sökningen kom tom. Recensionen renderas client-side, efter att servern redan skickat sitt svar. Den finns i DOM:en när man inspekterar elementet i en riktig webbläsare, men det är inte det Googlebot garanterat hinner se i tid, och definitivt inte det AI-crawlarna ser alls med dagens arkitektur.
Två metoder, samma produktsida, samma slutsats, sedär!
Enkel princip, egentligen
Recensioner, produktinformation och annat unikt UGC, särskilt sånt konkurrenterna inte har, bör så långt det går finnas server-side. Gör inte ert bästa innehåll beroende av att crawlern beter sig som en webbläsare.
Källor:
Om du vill ha någon som säger att allt går bra finns det gott om sådana.
Om du vill ha någon som hittar flaskhalsen och löser den, då är det mer min gata.
Boka ett samtal med mig